Як я зібрав для Kindle тлумачний словник української мови з радянського СУМ-11, нерівного Вікісловника і півтори тисячі тлумачень від ШІ, і чому кращого джерела досі немає.
Чотири файли, 139 тисяч статей і 1 604 цитати Леніна.
2026-10-2512 хв2 600 слівnotes / 04
Kindle показує значення слова, якщо втримати на ньому палець. Для англійської це працює з коробки. Для української - ні: тлумачного словника української мови для Kindle не було. Принаймні я його не знайшов.
Тепер він є. Його можна безкоштовно завантажити з GitHub, поставити за кілька хвилин і більше не гуглити кожне незнайоме слово. Ця стаття про те, як він з’явився, з чого він зібраний і чому жодне з джерел, які в нас є, не годиться без застережень.
01Звідки взялась ідея
Я читав «Відьмак. Меч призначення» Анджея Сапковського українською [1]. Світ аля середньовічний, переклад йому під стать: багато архаїзмів і рідкісних слів, значення яких я або не знав, або вгадував із контексту.
Гуглити кожне слово набридає вже на третій сторінці. Відкласти читалку, взяти телефон, набрати слово, знайти нормальне тлумачення, повернутися і згадати, на чому зупинився. Англійською на тому самому Kindle достатньо втримати палець на слові.
Як це працює: Kindle сам обирає словник за мовою книжки, і коли втримуєш палець на слові, показує статтю у спливному вікні поверх тексту. Не треба виходити з книжки, а всі слова, які ти так шукав, можна додати в Vocabulary Builder, де їх потім можна переглянути. Для англійської, німецької чи іспанської словники вбудовані. Для української нічого такого немає.
Я пошукав готовий словник. Англо-українські для Kindle є, зокрема словник Балла від Павла Ляпіна, і він потім став для мене еталоном того, як це має працювати. Тлумачного українсько-українського я не знайшов. Тож вирішив зібрати сам.
Мій пристрій - Kindle 11-го покоління 2024 року з прошивкою 5.20. Це важливо, бо пізніше саме прошивка підкинула найдивнішу проблему.
02Що вийшло
В результаті у нас словник, який відкривається з будь-якої української книжки довгим натиском на слово. Рекомендований варіант має 139 526 статей і важить 199 МБ (на момент написання статті). Що він вміє:
Будь-яка форма слова. «Абажуром», «писала», «кажучи», «найменшого» відкривають «абажур», «писати», «казати», «менший». Усього близько 4 млн форм.
Початок речення. «Ганком» з великої літери теж знаходиться.
«ґ» і «г». «Ґанок» знаходиться і в старому написанні «ганок», і навпаки.
Західні форми. «Войте», «шклисті» відкривають «війт», «склистий».
Без глухих відсилок. «Хоругва» («заст. Корогва») одразу показує і значення «корогви». Так розгорнуто близько 9,5 тис. статей.
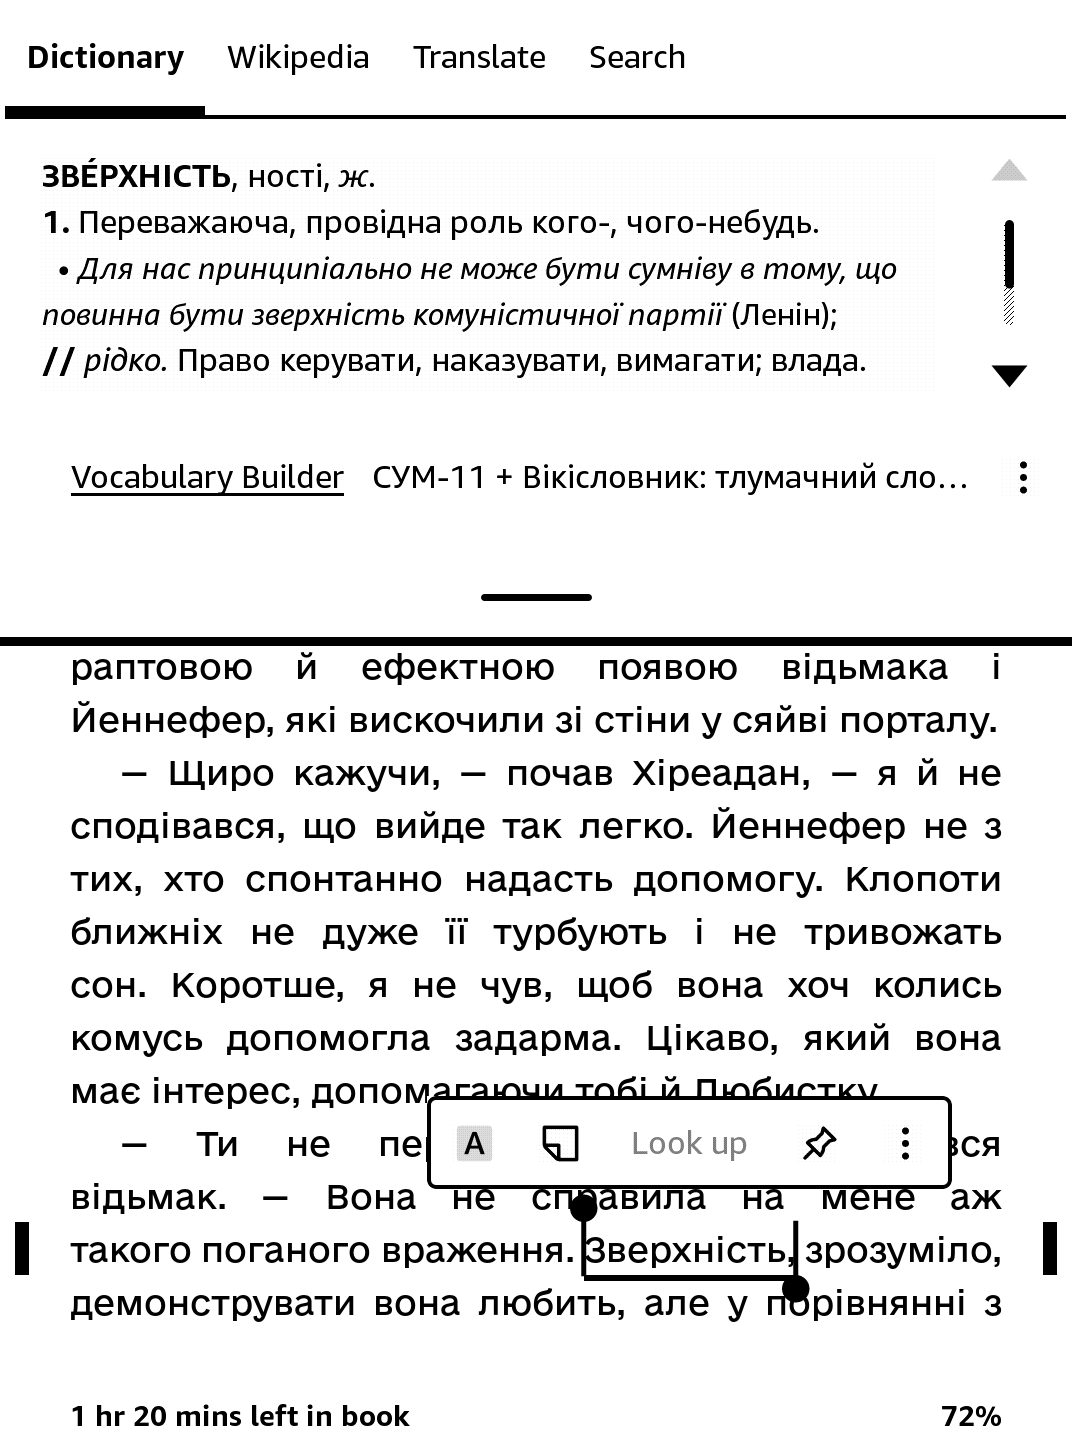
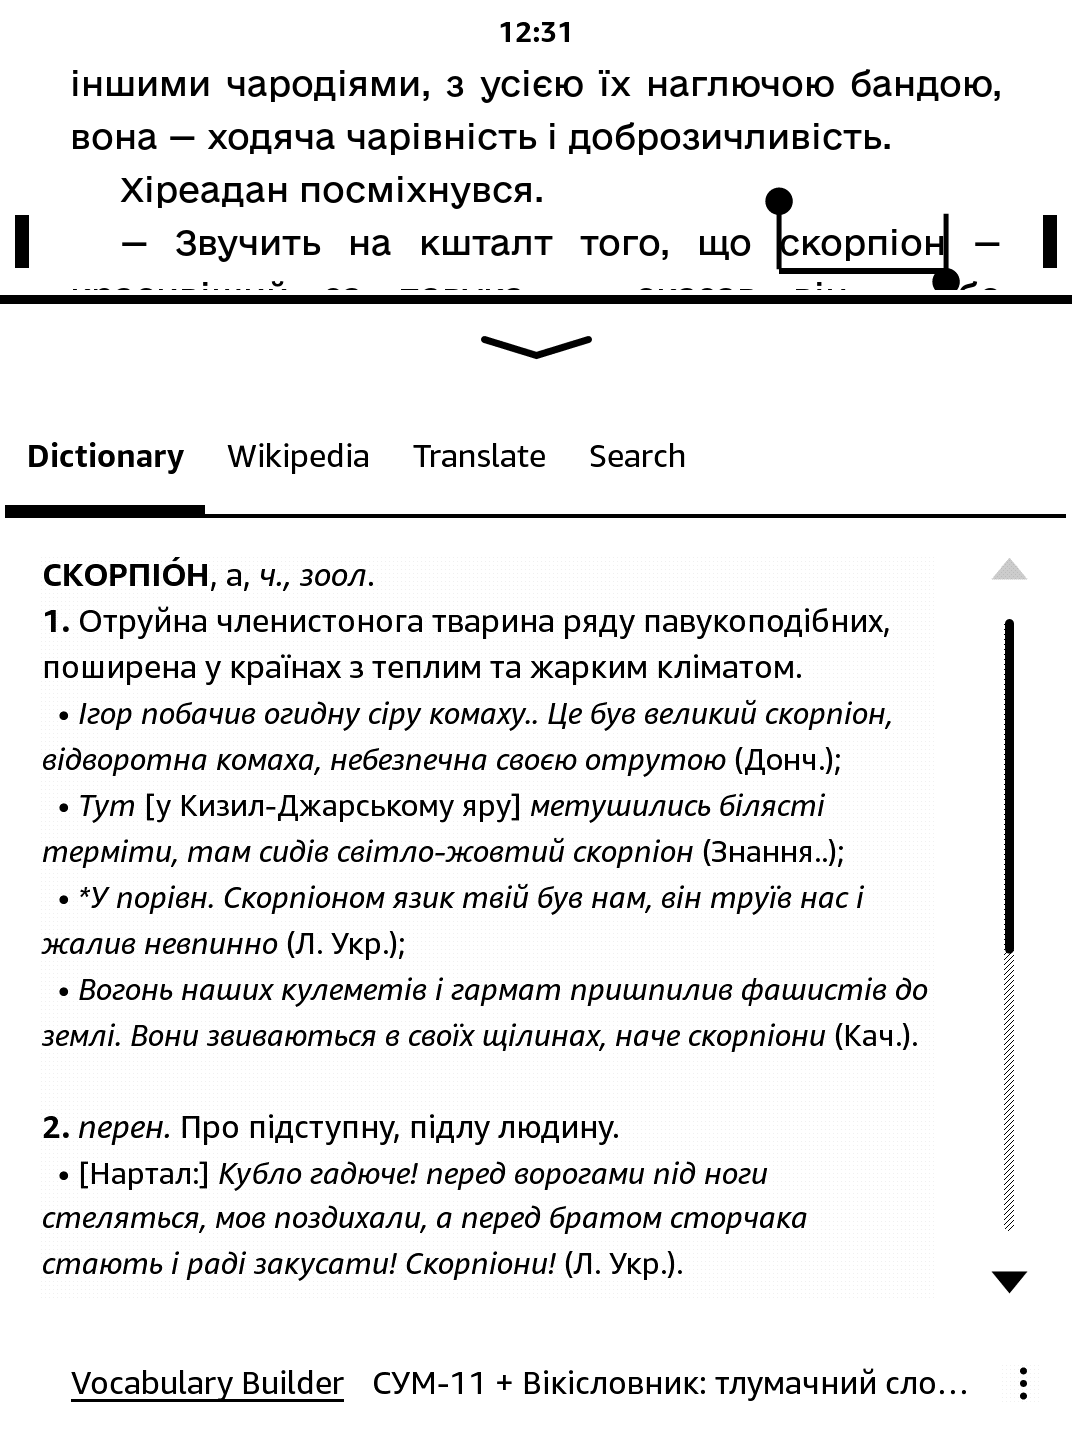
Ліворуч - спливне вікно над книжкою, праворуч - розгорнута стаття. Скріншоти з мого Kindle.
Файлів чотири, бо джерела різні і в кожного свої вади. Про них далі, а коротко: рекомендований бере все з СУМ-11 і додає Вікісловник та ШІ лише там, де не вистачає тлумачень від СУМ-11.
Чотири варіанти: СУМ-11 і Вікісловник (рекомендований), Вікісловник і СУМ-11, лише СУМ-11, лише Вікісловник.
Встановлення займає кілька хвилин. Інструкцію та самі словники можете знайти тут.
Єдиний повний академічний тлумачний словник української, текст якого можна взяти й обробити, - СУМ-11, «Словник української мови в 11 томах». Його укладали в Інституті мовознавства АН УРСР і видавали в 1970-1980 роках. Це величезна праця: понад 130 тисяч статей і сотні тисяч прикладів з літератури. І водночас це радянський словник у кожній деталі.
Перше-ліпше слово, в яке я ткнув для перевірки щойно зібраного словника, було «зверхність» з «Меча призначення». Ось перше значення і єдиний приклад до нього:
Переважаюча, провідна роль кого-, чого-небудь. Для нас принципіально не може бути сумніву в тому, що повинна бути зверхність комуністичної партії (Ленін, 31, 1951, 328).
Далі в тій самій статті - генуезці, що визнали зверхність золотоординських ханів, з «Історії СРСР», і Київ з «Історії УРСР». Для читача фентезі у 2026 році так собі супровід.
Я порахував, кого цитує СУМ-11. У даних, з яких зібрано словник, 323 655 цитат. Ленін серед них 1 604 рази, «Програма КПРС» - 398, «Статут КПРС» - 161, газета «Радянська Україна» - 3 711, журнал «Комуніст України» - 2 344. Разом із радянськими підручниками історії це понад 10 тисяч цитат у 8 336 статтях [5].
І це не лише про політичні слова. Ось приклади до звичайних, щоденних:
слово
приклад у СУМ-11
джерело
релігія
«Релігія є опіум народу»
Ленін
школа
«Радянська школа — найпередовіша, найпрогресивніша школа в світі»
«Радянська Україна», 1954
культура
«Передові діячі російської культури приділяли велику увагу українському народу…»
«Комуніст України», 1967
друг
«Як трудівник, селянин — друг пролетарської держави…»
Ленін
демократія
«Пролетаріат не може перемогти інакше, як через демократію»
Ленін
щастя
«— Так ви… і товариша Леніна бачили? <…> — І випаде ж щастя таке!»
Головко, 1957
А ось кого там немає зовсім: Хвильового, Підмогильного, Стуса, Багряного, Винниченка, Антонича. Нуль цитат. Словник показує мову такою, якою її дозволяли бачити в 1970-х. Укладачі СУМ-20 самі оцінюють, що «рудименти тоталітарної доби» становили в 11-томнику до 20 % обсягу [2].
Це не робить СУМ-11 непотрібним. Тлумачення там точні й докладні, а найчастіше цитовані автори - Коцюбинський, Панас Мирний, Гончар, Франко, Леся Українка, Нечуй-Левицький. Для рідкісних і архаїчних слів, заради яких словник і відкривають, кращого відкритого джерела немає. Але натрапляти на партію посеред фентезі - це спадок, з яким доводиться жити, бо альтернативи немає.
04СУМ-20: шістнадцять років, шістнадцять томів
Альтернатива мала бути. У 2010 році вийшов перший том «Словника української мови у 20 томах», СУМ-20. Його роблять в Українському мовно-інформаційному фонді НАН України на основі СУМ-11: переписують радянські тлумачення, додають слова й авторів, яких замовчували. Станом на 2026 рік вийшло 16 томів із 20, від «А» до «ряхтливий» [2].
У 2016 році науковий керівник проєкту Володимир Широков казав, що «вже є вся база даних цього 20-томника», а видавати виходить лише по тому на рік через фінансування. Щоб друкувати 3-4 томи на рік, треба було близько 10 млн грн щороку [3]. Відтоді минуло ще десять років.
Якщо подивитися на роки виходу, темп справді приблизно том на рік: перший у 2010-му, десятий у 2019-му, п’ятнадцятий у 2024-му, шістнадцятий у 2026-му [2]. Лишилося чотири. Якщо нічого не зміниться, двадцятий вийде на початку 2030-х, через двадцять років після першого. І навіть до виданих томів є питання: філолог Орест Друль у 2020 році писав про цитати, перенесені з СУМ-11 з помилками в авторстві [2].
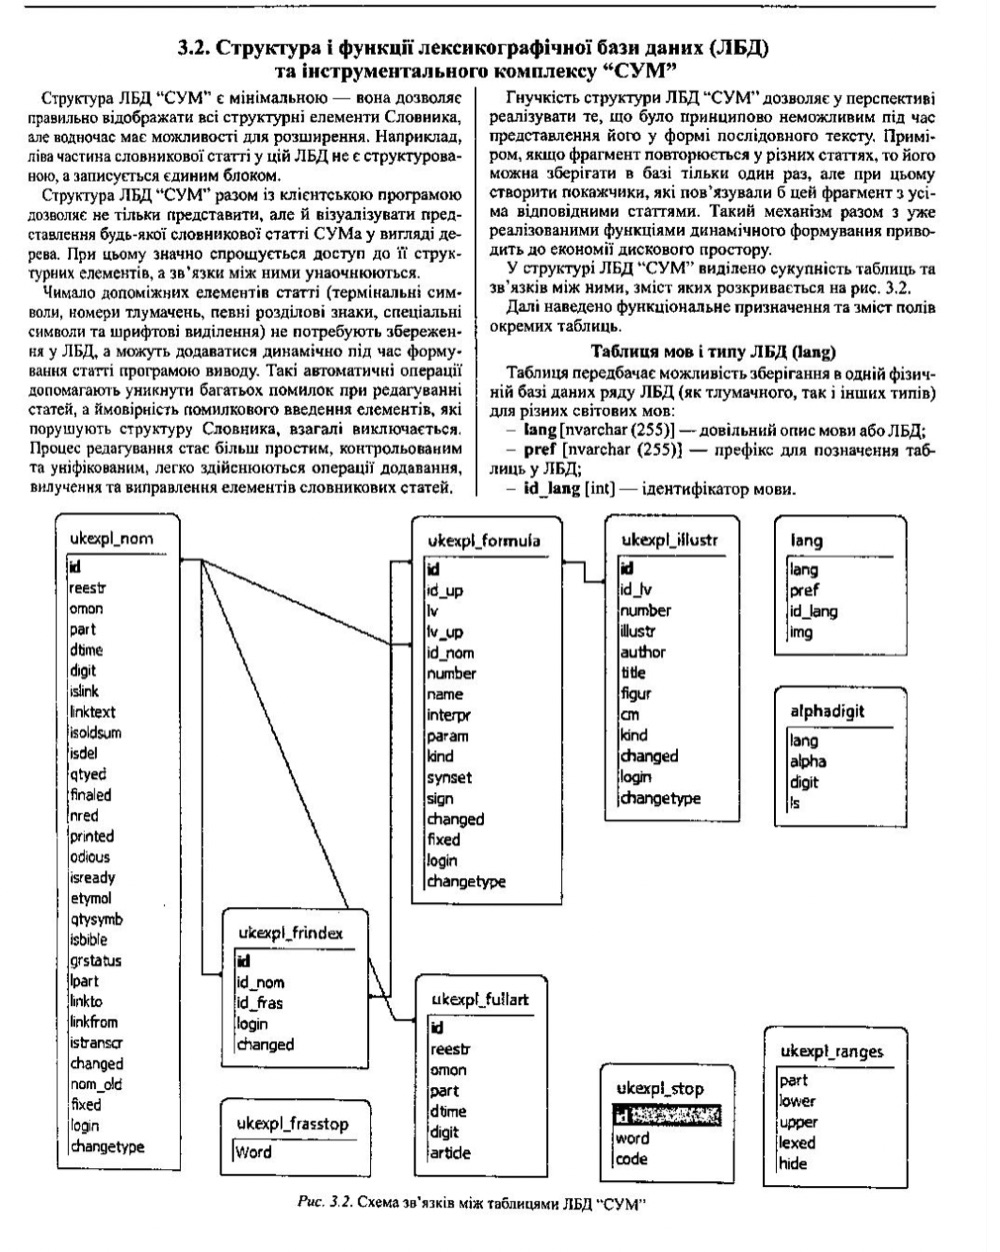
Найболючіше для мене інше. У першому томі СУМ-20 є цілий розділ про технологію: як СУМ-11 сканували, двічі вичитували, конвертували в HTML і розбирали в лексикографічну базу даних. Таблиці цієї бази описані там детально, аж до типів полів [4].
Схема таблиць бази даних СУМ-20. Перший том СУМ-20 (2010), розділ 3.2.
Навіщо знадобилася база, там пояснюють так:
Слід відзначити, що робота з ЛБД у форматі електронного тексту такого значного обсягу (понад 135 мегабайтів дискового простору) є абсолютно неефективною.
Навіть для 2010 року логіка не зрозуміла. У тому ж першому томі СУМ-20 описується програма, для якої потрібно встановити .NET Framework, а він важить 232 МБ! А сьогодні 135 МБ - це взагалі 20 фоток з телефону. Мій найбільший файл словника важить 199 МБ, і Kindle шукає в ньому миттєво. База зібрана, схема описана в книжці, а відкритих даних так і немає. Читати СУМ-20 можна лише на сайті, по одному слову.
А сам сайт не працює. Я заходив на нього вже разів 20, і завжди бачив Error.
На GitHub є спроби витягти СУМ-20 в JSON із сайту, але без ліцензії, з приміткою автора, що словник «не захищений авторським правом», і лише 16 томів. Тому словник для Kindle поки що зібраний з СУМ-11.
05Чия це ліцензія
Окреме питання, на яке я так і не знайшов відповіді: на яких умовах взагалі можна використовувати ці словники.
СУМ-11 видала «Наукова думка» в 1970-1980 роках. Явної ліцензії на текст я не знайшов ніде.
Дані, з яких зібрано мій словник, лежать на GitHub під AGPL-3.0. Але цю ліцензію поставив автор репозиторію, а не укладачі чи видавець.
СУМ-20 відкритий для читання онлайн, але умов використання тексту на сайті я теж не знайшов.
Виходить, що головні словники мови роблять за державні гроші, а що з ними можна робити людям, ніде не написано. Я зробив, як міг: код словника відкритий під AGPL-3.0, тексти Вікісловника йдуть під їхньою CC BY-SA 4.0, а джерело СУМ-11 вказане в кожній статті. Якщо хтось із правовласників це прочитає і захоче поговорити, мої контакти є на головній.
06Вікісловник: сучасний, але нерівний
Другим джерелом став український Вікісловник. Його пишуть волонтери, він живий і без радянщини, там є «інтернет», «ґрунт» і «п’ять». Але він маленький і дуже нерівний: поруч зі статтями на цілий екран з прикладами й синонімами є статті на два слова [6].
СУМ-11
Вікісловник
статей
131 155
19 915
медіанна довжина статті
223 знаки
98 знаків
коротші за 80 знаків
22 %
42 %
з прикладами вживання
71 %
37 %
Типова коротка стаття у Вікісловнику виглядає так:
вдалечінь - «те саме, що вдалину»
правдомовність - «властивість за знач. правдомовний»
бланя - «зах. хутро»
Ще там тисячі статей про прізвища, імена й села. Kindle спершу шукає точне написання, тож «Щастя» на початку речення відкривало статтю про місто Щастя, а не про щастя. Власні назви довелося вирізати.
Тому файлів чотири. Рекомендований бере все з СУМ-11, а Вікісловник лише закриває слова, яких там немає. Якщо радянські формулювання дратують сильніше за короткі статті, є варіант навпаки: спершу Вікісловник, а СУМ-11 лише там, де у Вікісловнику порожньо або тільки відсилка.
07Дірки в даних СУМ-11
Коли я почав перевіряти словник на справжніх книжках, частина звичайних слів не знаходилась. Близько 0,5 % слів у тексті - здається, небагато, але це слова на кшталт «проти» і «прямо», які трапляються на кожній сторінці.
Виявилось, що в цифрових даних СУМ-11 бракує цілих алфавітних блоків. Це не помилка мого парсера: в усіх форматах відкритого релізу по 127 тисяч записів замість приблизно 134 тисяч у паперовому словнику. Пропущено:
від «прот…» до «пущ…»: проти, професор, процес, прямо, пташка, пустеля
частина «прост…»: простягти, просторий
від «замус…» до «зао…»: занадто, заняття, заодно
«п’я…»: п’ять, п’ятниця, п’яний
«об’…»: об’єкт, об’єднати, обов’язок
окремі слова: ґрунт, ґудзик, дзиґа
Тобто в найповнішому відкритому тлумачному словнику української немає слова «проти». Частину цих дірок закриває Вікісловник («п’ять», «ґрунт», «професор»), решту - наступне джерело.
08Claude там, де пропущено
Для слів, яких немає ні в СУМ-11, ні у Вікісловнику, тлумачення написав Claude, модель від Anthropic. Таких статей близько 1 500. Це слова з дірок («проти», «прямо», «пташка», «занадто»), сучасна лексика («процесор», «нейромережа», «ШІ», «дипфейк», «кринж») і рідкісні книжні слова, на які я натрапляв у книжках («ґлейт», «фактотум»).
Усі вони лежать в одному відкритому файлі. Формат простий: слово, заголовок з наголосом, граматика, значення:
~/claude.tsvtsv
дипфейк ДИПФЕ́ЙК -у, ч. Підроблене за допомогою штучного інтелекту відео, зображення чи запис голосу…ґлейт ҐЛЕЙТ -у, ч. іст. Охоронна грамота: документ, що гарантував власникові безпечний проїзд…фактотум ФАКТО́ТУМ -а, ч. книжн. Довірена особа, що виконує найрізноманітніші доручення свого господаря…
Кожна така стаття в словнику підписана «— Claude (ШІ)». ШІ може помилитись, і я це не ховаю: будь-яке тлумачення можна перевірити у файлі, а помилку надіслати через issue на GitHub. У варіантах «лише СУМ-11» і «лише Вікісловник» тлумачень від ШІ немає зовсім, тож хто їм не довіряє, просто бере ці файли.
Як на мене – краще чесно підписане тлумачення від ШІ, ніж «не знайдено визначення» посеред речення.
09Як ми це робили
Словник я робив разом із Claude Code. Розподіл був приблизно такий: він писав код, шукав формати й документацію і розбирався, чому Kindle поводиться саме так. Я ставив задачі, тестував кожну збірку на своєму Kindle, ставив питання і сам шукав, коли щось не сходилося. Перша версія вийшла 20 жовтня, за п’ять днів - шість релізів.
версія
дата
що змінилось
v1.0
20 жовтня
СУМ-11 для Kindle
v2.0
21 жовтня
додано Вікісловник, чотири варіанти файлу
v2.1
21 жовтня
новий вигляд статей і точніший пошук
v2.2
21 жовтня
обкладинки й короткі назви
v2.3
21 жовтня
тлумачення від Claude у змішаних словниках
v2.4
25 жовтня
розгорнуті відсилки, інші написання, нові слова
Більше часу пішло не на сам словник, а на Kindle, який є клятою закритою машиною. Кілька речей, які довелося з’ясовувати на пристрої:
kindlegen не підходить. Офіційний інструмент Amazon сортує український індекс не в тому порядку, в якому Kindle по ньому шукає. Словник збирається без помилок, але з книжки не знаходиться нічого. Допоміг kindling, відкритий збирач, який сортує так, як шукає пристрій.
Спливне вікно ігнорує CSS. Тому вся верстка статті зроблена жирним, курсивом, розміром шрифту і переносами рядків.
Велика літера. Kindle не переводить слово на початку речення в нижній регістр, тож усі форми з великої літери довелося індексувати окремо.
«Мені» відкривало «мень». Якщо форма належить двом словам, Kindle відкриває перше за індексом, і «мені» вело до статті про рибу мень, а не до «я». Частот слів для української в pymorphy3 немає, тому частоту рахуємо в тексті самого словника: це 7,6 млн слів, з них 5 млн у цитатах. Спільна форма дістається частішому слову.
Порожня обкладинка. kindling записує в файл ідентифікатор, схожий на ASIN. Kindle, побачивши ASIN, іде по обкладинку в магазин Amazon, не знаходить її і показує в бібліотеці порожню плитку. Після збірки ці записи перейменовуються, і обкладинка з’являється.
Апостроф на прошивці 5.20. На моєму Kindle слова з апострофом усередині («сум’яття», «здоров’я») не знаходяться. «З’явився» вдалося полагодити окремим індексом, решту поки ні.
Повний список пасток з поясненнями є в README репозиторію.
10Що кажуть люди
Я виклав словник у Threads. Кілька відгуків звідти:
О, круто, я звикла, що будь-яке слово англійською можу одразу подивитись тлумачення, а тут читала книгу українською, і деякі слова взагалі не вдупляла.
Дякую! Це дуже крута штука! Нарешті можна не гуглити так багато.
Дякую, встановила і вже користуюся! Клас!
Що я бачу перед собою? Це скарб.
11Що далі
Найкраще, що могло б статися з цим проєктом, - щоб його замінило щось краще з офіційного джерела. Для цього не треба нових грантів чи років роботи:
Відкрити дані СУМ-20 під зрозумілою ліцензією. База зібрана, схема описана, 135 МБ давно не проблема.
Прямо написати, на яких умовах можна використовувати СУМ-20.
Більше людей у Вікісловнику. Кожна докладна стаття звідти потрапляє в наступну збірку словника.
А поки що: завантажуйте, ставте, і якщо слово не знаходиться чи тлумачення від ШІ помилкове, пишіть в issues на GitHub.
[1]Окремий біль: жодну книгу серії «Відьмак» українською зараз неможливо купити в електронному вигляді файлом. Паперові книжки є, а електронні легально не продають ніде. Виявляється, електронні книжки теж можуть «закінчитися». Щойно вони з’являться в продажу, я їх куплю, навіть якщо вже дочитаю.
[2]Вікіпедія, «Словник української мови у 20 томах»: перелік томів і оцінка укладачів щодо «рудиментів тоталітарної доби» в СУМ-11.
[3]Інтерфакс-Україна, 24 жовтня 2016; передрук на сайті Українського мовно-інформаційного фонду НАН України (ulif.org.ua).
[4]Словник української мови у 20 томах, т. 1 (Київ: Наукова думка, 2010), розділ 3 «Технологічні аспекти проекту „СУМ-20“».
[5]Підрахунок за даними СУМ-11 з релізу ukr-ukr_SUM-11_or_1: 127 071 запис; джерело цитати - перше слово в дужках після прикладу. У даних бракує близько 5 % статей паперового словника, тож точні числа можуть трохи відрізнятися.
[6]Довжина й частки пораховані за текстом статей у зібраних файлах словника, без форм слів. Кількість статей - з файлів «лише СУМ-11» і «лише Вікісловник».
AV
Andrii Volkov · @volkovskey
Software-інженер · Системний розробник · Дніпро / Україна